
【导读】9月22日,2026云栖大会上,阿里云正式推出面向下一代AI训练集群的新一代高性能存储CPFS(Cloud Parallel File Storage),提供高达百TB/s级吞吐和亿级IOPS,单文件系统规模提升5倍至100PiB,为百万卡模型训练加速,支撑大规模模型训练和多模态数据处理。在实际训练中,可将模型启动平均耗时降低50%、峰值算力利用率提升30%、AI存储成本降低69%,业务承载能力翻倍。
随着大模型训练进入规模化阶段,数据集由文本扩展至图片、视频和语音,规模可增长50倍甚至百倍;模型参数规模增长约10倍,Checkpoint保存也更加频繁。海量小文件并发读取和 Checkpoint 突发写入由此成为新瓶颈,存储如果无法跟上,昂贵的GPU集群就会因数据供给不足而空转。
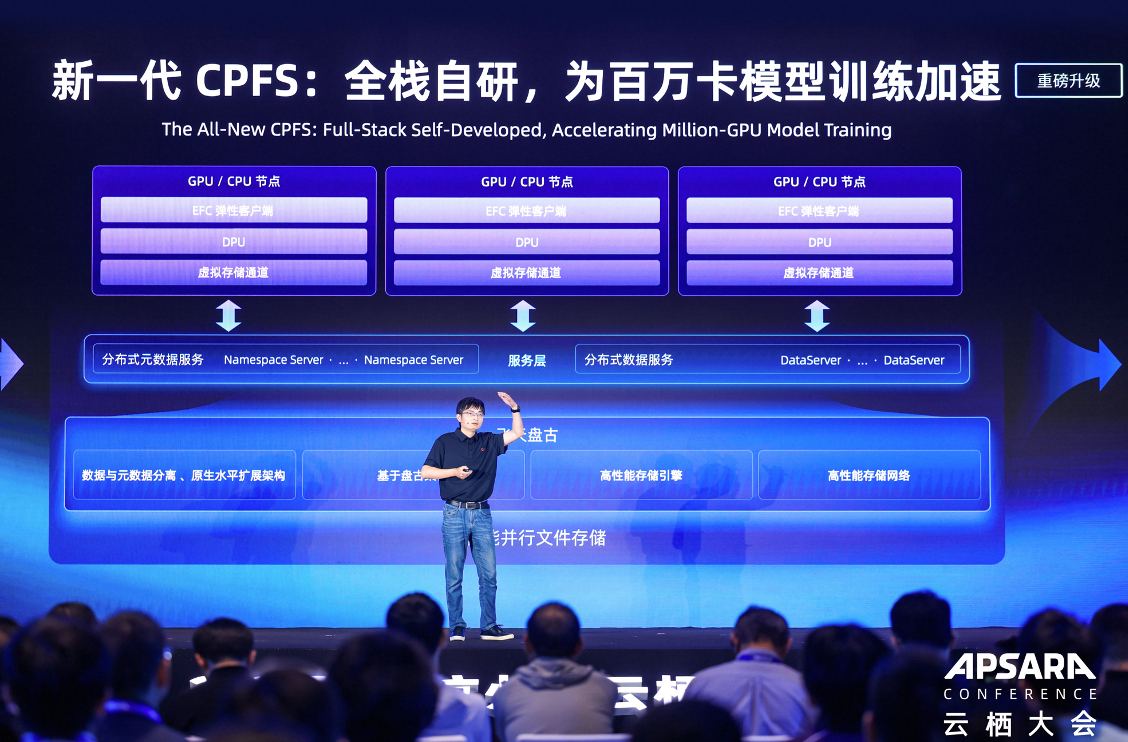
针对这一问题,新一代CPFS采用数据服务与元数据服务分离架构,实现容量和性能的水平扩展。GPU、CPU节点通过EFC弹性客户端和虚拟存储通道,接入分布式元数据和数据服务;结合飞天盘古的分布式持久化存储底座和高性能存储网络,形成从客户端、协议处理到数据落盘的全链路自研链路。
据悉,新一代CPFS文件系统容量规模提升5倍、元数据性能提升10倍、文件数量规模提升100倍,单文件系统可扩展至百PiB并承载万亿级文件。企业无需为不同训练阶段反复拆分或迁移数据,即可在统一文件系统中管理训练语料、模型参数、Checkpoint和实验结果,并随GPU集群同步扩展容量与吞吐。
针对冷热数据长期并存带来的成本压力,CPFS还提供智能生命周期管理和冷热分层存储,使不同访问频率的数据自动匹配合适的存储介质,在保障训练性能的同时,整体存储成本最高降低69%。以Qwen大模型训练为例,采用新一代CPFS后,模型启动平均耗时降低50%,峰值算力利用率提升30%,业务承载能力翻倍。
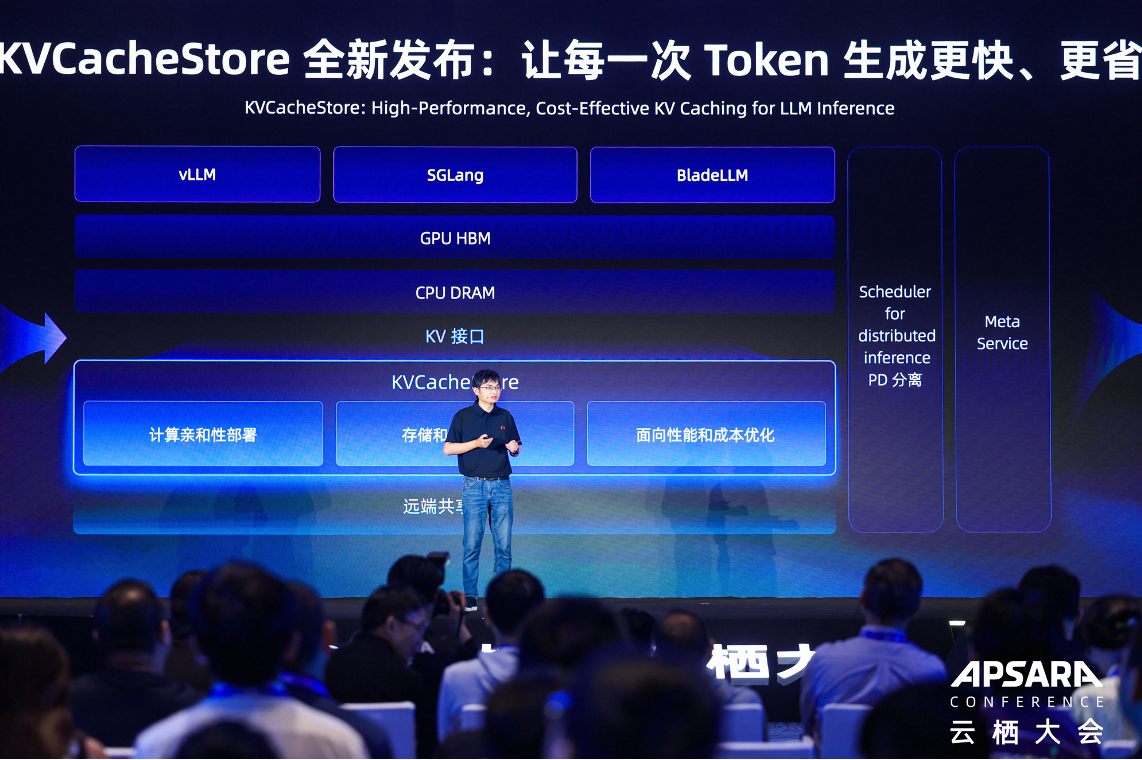
面向大模型推理,阿里云同时推出KVCache加速引擎——KVCacheStore。它位于GPU显存、主机内存与远端共享存储之间,是基于近计算部署、高性能网络和弹性共享存储构建的新型G3.5存储层,以“存储换计算”承接长上下文、多轮对话和复杂Agent任务产生的大量缓存。KVCacheStore支持与算力亲和部署,单计算节点吞吐达到40GB/s,通过Batch接口实现百万QPS,单实例可满足千亿级KV存储规模,实测缓存命中率提升20%以上。
“每一次模型的跃迁,都是云存储自我革新的最佳契机。”阿里云存储产品负责人蒋江伟表示,阿里云将持续推进算、网、存协同创新,让数据更快进入计算、GPU得到更充分利用,为大模型训练和AI应用提供高性能、可扩展且成本可持续优化的存储底座。
结论
新一代CPFS并行存储的升级,彻底补齐了大规模AI训练场景的存储短板,通过架构分离、全链路自研与智能冷热分层,有效提升GPU算力利用率、缩短模型启动时间、大幅降低存储成本。配套推出的KVCacheStore推理加速引擎,则针对性解决长上下文对话与Agent任务的缓存压力,进一步释放集群推理性能。此次双产品升级,实现了大模型训练与推理全流程存储优化,依托算网存深度协同能力,为超大规模AI集群落地提供更高效、更稳定、更具性价比的底层支撑。