【导读】随着神经网络在解决复杂机器学习问题中展现出卓越能力,其日益增长的模型规模与计算复杂度也成为了落地应用的主要瓶颈。特别是在资源极其受限的嵌入式系统(如低功耗MCU)上,巨大的内存占用(ROM)和高昂的运算量(MACs/FLOPs)往往使得高性能模型难以部署。如何在严格保持模型精度的前提下,大幅压缩模型体积并降低推理成本,成为连接先进算法与边缘硬件的关键挑战。本文将深入探讨神经网络模型压缩的核心原理,同时介绍Reality AI Tools®如何让这一复杂的压缩过程变得自动化且对用户透明。
1.为什么需要神经网络模型压缩?
神经网络已经成为解决复杂机器学习问题的强大工具。然而,这种能力往往伴随着模型规模和计算复杂度的增加。当输入维度较大(例如长时序窗口、高分辨率特征空间)时,模型需要更多参数、每次推理需要更多算术运算,使其难以部署在嵌入式硬件上。
对于嵌入式系统而言,资源极其有限。内存空间受限,因此在桌面或云平台上轻松运行的模型可能无法放入芯片内的闪存。此外,较高的运算量(MACs/FLOPs)和推理延迟要求往往超出低功耗MCU或边缘设备所能承受的范围。
我们要解决的核心挑战是:如何在保持模型性能的前提下,大幅压缩神经网络模型,降低模型大小、推理时间和计算成本,从而实现其在资源受限的嵌入式系统上的部署。
2. 神经网络模型压缩是如何工作的?
神经网络模型往往比实际需要的更大。在训练和验证之前,我们很难准确判断架构规模是否合理。模型压缩的目标就是识别模型中的冗余和未充分利用的权重并将其移除。
我们使用专有的数学方法来寻找并压缩这些冗余,对网络进行重新整理,使其更加简洁、小巧和高效。同时,我们会严格控制精度损失,确保不会丢弃过多关键信息。
3. 实例:紧急尖叫声检测(Emergency Scream Detection)
为了更直观地解释这一挑战,我们以“紧急尖叫声检测(ESD)”演示为例。ESD系统是一种机器学习模型,用于区分求救尖叫声和其他环境声音。该任务是一个二分类问题:Scream vs Not Scream。
模型使用Google’s Audioset database公共数据集中的音频信号进行训练。训练数据集规模大且多样化,而验证数据集由团队采集的小规模现场录音构成。模型在训练集的k-fold验证中表现中等,但在新的现场数据上表现非常好。
基线模型性能:
我们使用基于全连接层的神经网络,并以STFT频谱图作为输入特征。该模型取得了最佳效果,达到:
• k-fold验证精度:82%
• 现场数据测试精度:98%
从性能角度看,该模型表现优秀。然而,它有一个关键问题:
• ROM占用:552kB
该大小超过目标嵌入式平台(Voice RA6E1)的内存限制,导致无法部署。
压缩模型性能:
为了解决这一问题,我们应用了Renesas为嵌入式部署优化的专有神经网络压缩技术。
压缩结果非常显著:
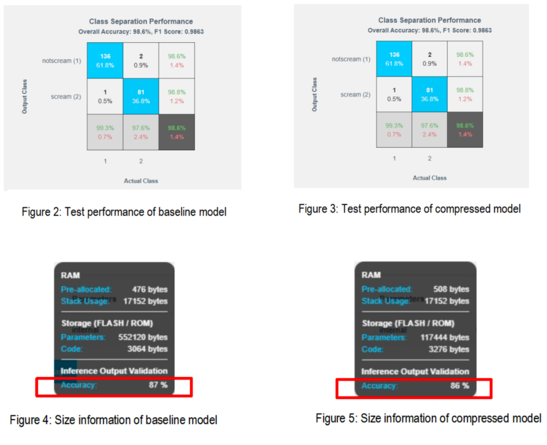
• 模型大小从552kB降至117kB(减少约79%)
• k-fold验证精度保持82%
• 现场测试精度保持98%
• MAC从129,68 降至21,001(降低83%)
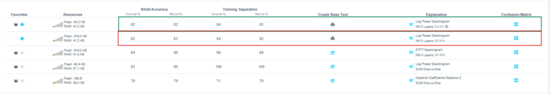
Figure 1: Comparing baseline and compressed model on RealityAI
也就是说,在几乎不影响模型性能的前提下,显著减少了模型规模和计算成本。
图1–5展示了该对比的详细信息。图1显示AI Explore™的对比结果;图2和图3的混淆矩阵确认精度保持一致;图4和图5的红框部分(Flash Parameters)展示了模型大小和复杂度的核心差异,该数值反映了实际编译后部署的模型,比Explore页面上的估算更准确。
4. 更多成功案例
表1汇总了其他示例模型的结果——其中,资产移动跟踪模型使用加速度计数据来识别设备或包裹的搬运与移动状态;吸尘器地面类型检测模型通过电机信号判断清扫对象的地面材质;电机启动负载检测模型能够在开环控制下快速判断电机的启动负载,从而帮助控制器实现节能优化。
从这些实验结果可以看到,模型在压缩后的准确率基本得以保持。两个项目在压缩前后完全没有精度损失(紧急尖叫检测:98% → 98%,电机启动负载:99% → 99%),其余两个项目的变化也仅为1%的轻微下降(资产移动:92% → 91%,吸尘器地面类型:96% → 95%)。
在保持精度几乎不变的同时,模型体积显著减小。尤其是较大的基线模型,ROM 使用量减少超过75%。同时,MAC(Multiply-Accumulate)运算量也呈现同等幅度的下降,与 ROM 节省情况高度一致。
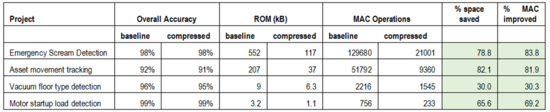
Table 1: Comparison of baseline and compressed models
5. 使用 Reality AI Tools®进行模型压缩
在Reality AITools®中,对神经网络模型进行压缩、重新训练、使用新数据进行测试以及部署到目标板上,都非常简单。事实上,在AI Explore™阶段,工具会自动完成模型压缩——你甚至不需要额外关注这一步骤。
下面是一段精简的流程说明,展示你将会看到的主要步骤。
(1) 首先,在Data→Curate模块中创建你的训练集和测试集。
(2) 在AI Explore™页面中训练模型,并探索不同的特征空间与决策结构。点击“Start Explore”后,系统会自动训练和测试多种模型,并根据性能对它们进行排序。在Explore的结果中,你会同时看到部分模型的基线版本与压缩版本。当某个基线模型在不降低准确率的情况下可以进一步缩小体积时,工具会自动生成其压缩版本。压缩模型会使用一个特殊符号标记 (如图7中红色箭头所示)。相反,没有该符号的则是未压缩的原始基线模型。
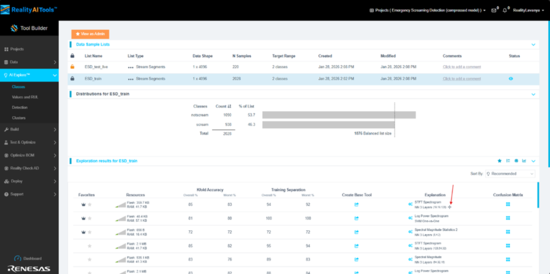
一旦你确定了需要进一步评估与部署的模型,可以从该模型创建一个Base Tool,以便继续开展后续工作。此时,压缩后的模型即可用于重新训练、测试、优化以及部署,使用方式与原始基线模型完全一致。
对于用户来说,使用压缩模型是完全透明的。它在系统中会像其他任何Trained Tool模型一样工作,不需要额外步骤或特殊处理。
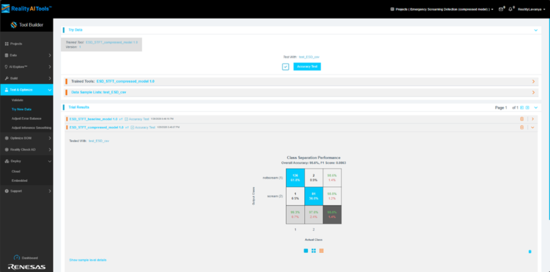
(3) 你可以在Test & Optimize→Try New Data区域测试压缩后的模型。选择压缩版本的Trained Tool模型以及所需的测试数据集,然后运行Accuracy Test(准确率测试),即可评估该模型在未见过的数据上的表现。
(4) 部署同样非常简单。在验证压缩模型并确认其性能符合预期后,你可以进入Deploy→Embedded完成部署流程。选择已经训练好的压缩模型,并根据目标嵌入式系统的约束条件创建新的部署包。随后,下载生成的可导出模型包,并将其部署到目标硬件板上。与Reality AI Tools®中其他模型的部署方式完全一致,使用压缩模型无需任何额外步骤或特殊处理。
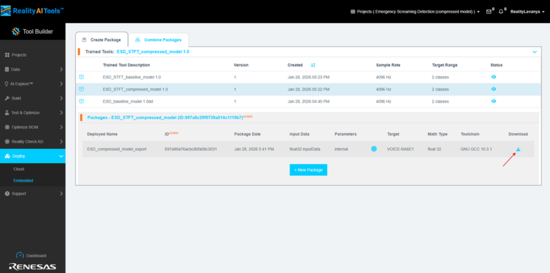
Figure 9: Export compressed model
总结
神经网络模型压缩并非以牺牲性能为代价的妥协,而是实现边缘智能部署的必要优化手段。通过识别并移除网络中的冗余权重,我们能够在几乎不损失精度(甚至在某些案例中完全保持原有准确率)的情况下,将模型体积缩减75%以上,并将计算负载降低逾80%。从紧急尖叫声检测到电机负载监测,多个成功案例证明了该技术在平衡高性能与低资源消耗方面的巨大潜力。更重要的是,借助Reality AI Tools®等现代化开发平台,模型压缩已不再是需要深厚数学背景的繁琐步骤,而是集成在自动化工作流中的透明环节。
 业界新闻