【导读】2026世界人工智能大会期间,国产算力技术迭代迎来关键突破。针对后摩尔时代AI算力普遍存在的高功耗、高延迟、高成本及通用性不足等行业难题,亿铸科技在「重构算力」产业链论坛上,正式发布通用存算一体三大行业定律,同步公开全数字3D DRAM通用存算一体AI芯片的完整技术架构、核心优势与商业化落地成果。企业凭借差异化的3D DRAM工艺与全数字架构路线,破解了传统算力架构及早期存算方案的诸多短板,凭借极致的能效与成本优势,为大模型推理、云端算力集群等核心场景提供了自主可控的国产算力解决方案,有效推动国内通用存算一体技术从技术验证迈入规模化商用阶段。
一、行业痛点:传统架构桎梏AI规模化落地
当前AI产业已从参数堆叠竞争,全面转向场景落地与商业化提质阶段,大模型迭代、Agent智能体普及,对算力的延迟、稳定性、能耗成本提出极高要求。传统冯·诺依曼存算分离架构存在天然短板,形成难以突破的“存储墙”瓶颈。
数据显示,现有算力架构中,数据搬运耗时与计算耗时比例达到100:1,绝大部分功耗与时间损耗均产生于数据传输环节。与此同时,行业早期存算一体方案普遍存在明显短板:RRAM、SRAM等介质方案容量仅为MB级别,无法支撑大模型参数部署;模拟计算路线易受温度、工艺、噪声干扰,精度误差累积严重,稳定性不足;多数存算产品仅可作为协处理器,通用性弱、生态适配难,难以落地云端大算力场景。
二、核心技术突破:3D DRAM+全数字存算一体架构革新
针对行业容量不足、精度不稳、通用性差三大难题,亿铸科技打造差异化技术路线,依托3D DRAM技术与全数字通用存算一体架构,实现底层算力架构的跨越式升级,规避了传统方案的各类短板。
在存储容量层面,亿铸科技依托3D堆叠工艺大幅提升芯片片上存储容量与带宽,彻底打破MB级容量天花板,可轻松承载百亿、千亿级大模型参数,满足云端算力集群高速吞吐、超长文本推理的算力需求。
在计算精度层面,企业放弃误差较大的模拟计算路径,采用纯数字电路架构,从根源上消除阻值漂移、工艺偏差、温变干扰带来的计算误差,保障多层神经网络运算、MoE稀疏计算场景下的高精度与高稳定性,适配商用大模型的严苛推理标准。
在通用能力层面,方案同时满足架构通用、生态通用、计算通用三大特性。架构不绑定单一存储介质,预留长期迭代空间;全面兼容CUDA、PyTorch双生态,无需重构上层代码,迁移成本极低;通过存算IP与通用计算模块异构融合,可独立完成全流程AI计算任务,摆脱传统存算方案的外设协处理器定位。
三、行业理论创新:通用存算一体三大定律正式发布
基于多年技术研发与产业实践,亿铸科技在本次大会首次提出通用存算一体三大定律,为行业技术选型、产业演进提供了标准化底层判断框架。
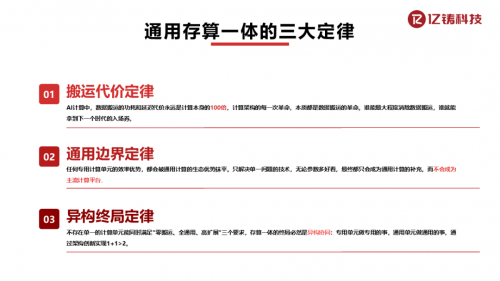
其一为搬运代价定律。算力架构的每一次核心突破,本质都是数据搬运效率的优化升级。AI计算功耗与延迟的核心损耗源于数据搬运,而3D DRAM大容量基底、存算一体架构减损、3D封装高带宽互联的组合方案,是当前破解AI算力瓶颈的最优技术路径。
其二为通用边界定律。专用计算的极致性能优势,终将被通用计算的生态优势抵消。单一功能的专用算力仅能作为补充,兼具低迁移成本、完善生态的通用算力方案,才是产业主流选择,这也印证了亿铸科技双生态兼容路线的前瞻性。
其三为异构终局定律。暂无单一计算单元可同时实现零搬运、全通用、高扩展,存算一体产业终局为异构协同。通过存算专用单元与通用计算单元深度融合、分工协作,可实现系统算力效能最大化,架构协同能力也成为行业核心技术护城河。
四、实测能效优势:十倍级综合能效,大幅降低算力TCO
目前亿铸科技全数字3D DRAM通用存算一体AI芯片已完成成功流片,实现从理论架构到硬件落地的全链路验证。经第三方权威测试核验,产品展现出十倍级综合能效优势,相比主流云端GPU综合竞争力大幅提升。
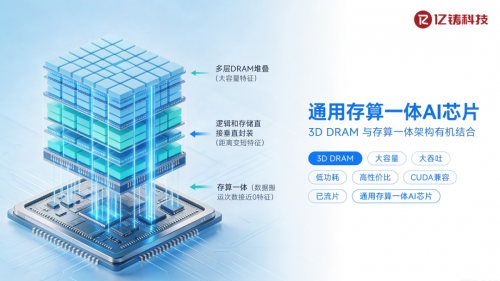
性能与成本维度,新品相较主流云端GPU性能提升2倍,功耗降低至原有五分之一,硬件成本仅为六分之一。在大模型推理核心场景,同等业务规模下整体TCO最高可下降88%,极大减轻数据中心、云计算企业的规模化部署压力。
场景适配维度,方案深度适配Agentic AI全新算力需求,支持1M超长上下文窗口、混合精度计算、集群级KV Cache池化等前沿能力,有效降低长文本推理延迟,提升大规模并行树搜索、环境模拟任务的算力吞吐,适配AI智能体迭代演进需求。
五、产品矩阵与产业价值:全场景覆盖,助力国产算力升级
依托全栈自研技术体系,亿铸科技已构建自主可控的核心技术栈,涵盖自研指令集、软硬协同异构架构、CUDA兼容编译器、专属算子库及算力组网系统,形成覆盖云、边、端的全场景产品矩阵,可适配云端大模型推理、算力集群部署、边缘智能设备等多元场景。
随着存算一体纳入国家“十五五”规划,国产自主算力进入加速发展窗口期。立足产业新赛道,亿铸科技最新进展补齐了国内通用存算一体商用化的短板,为行业提供了可落地、可规模化的底层算力方案。未来,亿铸科技将持续优化异构融合架构,迭代升级3D DRAM存算一体技术,联合产业链伙伴完善生态体系,持续释放高能效、低成本算力价值,为国产AI大算力自主可控、规模化落地筑牢底层根基。
结论
本次亿铸科技在世界人工智能大会的技术发布与成果公示,不仅是企业自身技术研发的重大跨越,更是国产通用存算一体算力赛道的重要里程碑。面对传统冯·诺依曼架构的固有瓶颈以及行业早期存算方案的各类局限,亿铸科技跳出模拟计算的常规技术路径,以3D DRAM堆叠工艺搭配全数字存算一体架构,有效解决了算力容量不足、运算精度不稳、场景通用性差等核心痛点,实现了算力性能、功耗、成本的全方位优化。

 业界新闻