技术应用

比CPU快一亿倍,港大造出原子级芯片!

发布时间:2026-08-10 00:00:00 来源:转载 责任编辑:lijiahuan

【导读】8月4日,香港大学工程学院官网发布了一项重磅科研成果:该团队成功研发出原子级厚度的“模拟存内搜索”芯片,特定任务运算速度远超标准CPU,提速高达1亿倍。这项突破性研究已刊发于国际顶级期刊《自然·纳米技术》,硬核实力获得了全球学界的认可。


在AI大模型和智能设备飞速迭代的今天,传统芯片面临着严重的算力天花板:数据来回搬运、运算速度变慢、能耗居高不下,这些问题成为了制约当前科技产业进一步发展的关键瓶颈。针对这一行业难题,香港大学研究团队给出了一份颠覆性的答案。


8月4日,香港大学工程学院官网发布了一项重磅科研成果:该团队成功研发出原子级厚度的“模拟存内搜索”芯片,特定任务运算速度远超标准CPU,提速高达1亿倍。这项突破性研究已刊发于国际顶级期刊《自然·纳米技术》,硬核实力获得了全球学界的认可。


可能很多人好奇:1亿倍提速到底是什么概念?这款芯片凭什么实现颠覆性突破?


其实,答案就藏在它的运算逻辑里!
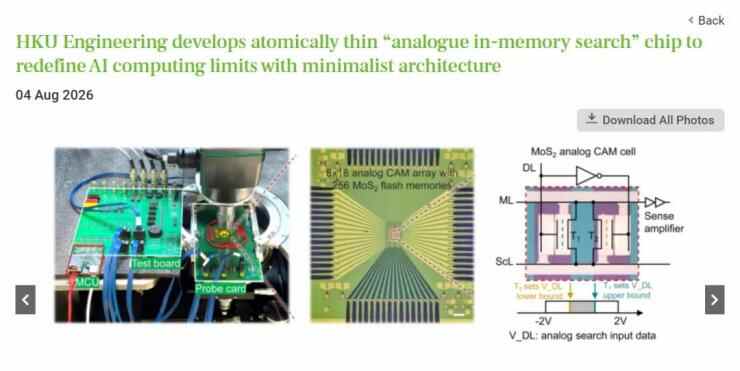

6a7340ff5e21e.jpg


(图片来源:香港大学官网)


在计算机领域,传统芯片因受制于“内存墙”问题而面临性能天花板,这便是业界熟知的冯·诺依曼瓶颈。处理器和内存是相互独立的2个模块,每一次数据运算都需要在两者之间反复搬运、传输数据。这个来回流转的过程,不仅极大拖慢了运算速度,还造成了大量能耗浪费,这也是多年来芯片性能难以跨越式提升的核心症结。而港大的这款全新芯片,直接从架构上绕开了这一痛点。


该团队创新性采用二维二硫化钼(MoS₂)闪存,打造出新型模拟内容寻址存储器(CAM)。不同于传统运算模式,它可以直接在数据存储位置完成复杂搜索运算,无需迁移数据。更厉害的是,它能在单个步骤内将输入数据与所有存储数据同步比对,瞬间输出精准结果,运算效率实现了质的飞跃。


在核心硬件设计上,这款芯片更是做到了极致精简。传统高端CAM存储单元,完成基础运算需要16个晶体管堆叠,结构复杂、体积庞大、成本高昂。而港大团队攻克技术难关,仅用2个晶体管就能构建1个完整单元,直接大幅压缩了芯片体积、提升了集成度,为微型智能设备适配打下基础。


不仅如此,为解决二维材料接入电路时的“肖特基势垒”难题,该团队还创新采用了半金属锑作为接触电极,成功搭建出极低电阻传输通道,彻底打通了数据传输壁垒,让芯片运行更稳定、更高效。


而最震撼的还是它的实测数据,每一项指标都刷新了行业极限:这款原子级芯片的搜索延迟仅36皮秒(0.000000000036秒),鉴于光在真空中每皮秒仅行进0.3毫米,这意味着芯片完成一次搜索运算的时间,甚至比光线穿过芯片自身所需的时间还要短。


在实现极致性能输出的同时,其能效管理也达到了行业顶尖水平,单次搜索能耗低于0.1飞焦耳。相比传统芯片方案,能耗降低上万倍,真正实现了“极速运算+超低功耗”的双重突破。


这项技术绝非实验室噱头,未来落地场景和价值极具想象空间。港大李灿教授表示,大语言模型的注意力机制,核心本质就是高频数据搜索运算。这款芯片的诞生,恰好精准适配了AI算力的核心需求。未来可广泛应用于智能手机面部识别、终端AI运算等场景,实现所有数据在设备本地直接处理,无需上传云端。


这意味着,未来智能设备的AI响应速度会更快,同时彻底规避了云端数据传输的隐私泄露风险,兼顾高效与安全。


从突破传统芯片架构桎梏,到极简硬件设计、极致能效表现,港大这款原子级芯片,不仅攻克了长期困扰业界的算力瓶颈,也为下一代存算一体芯片、轻量化AI终端的发展,开辟了全新赛道。


gg_20260512171736_266_20260622170931_179_20260707113844_971_20260708172203_213_20260710172006_775.png

CPU

为您推荐

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU 新品速递

链博会首发|云尖 R8260 N8 AI Agent 服务器:搭载 NVIDIA Vera CPU

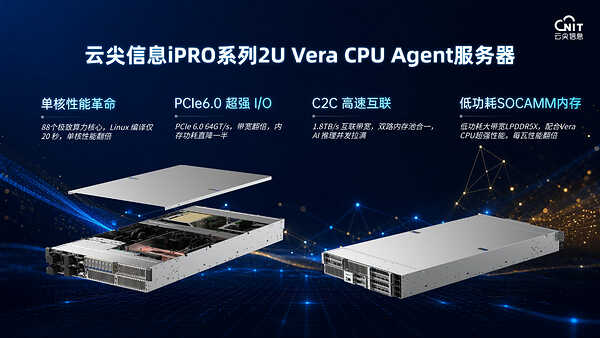
第四届链博会,云尖信息在 NVIDIA 展区发布 R8260 N8 AI Agent 服务器。这款 iPRO 系列 2U 机型搭载 NVIDIA Vera CPU,依托 PCIe 6.0、C2C 一致性互联,主打强单核、高带宽、低功耗,针对性解决 AI Agent 场景 CPU 拖累 GPU、KV Cache 受限等痛点,适配 AI 推理、企业级 Agent、HPC 等业务,兼顾性能与 TCO。

电源管理 互联技术 CPU Nvidia(英伟达)

AI 智能体正在重新定义 CPU 性能的评估标准 业界新闻

AI 智能体正在重新定义 CPU 性能的评估标准

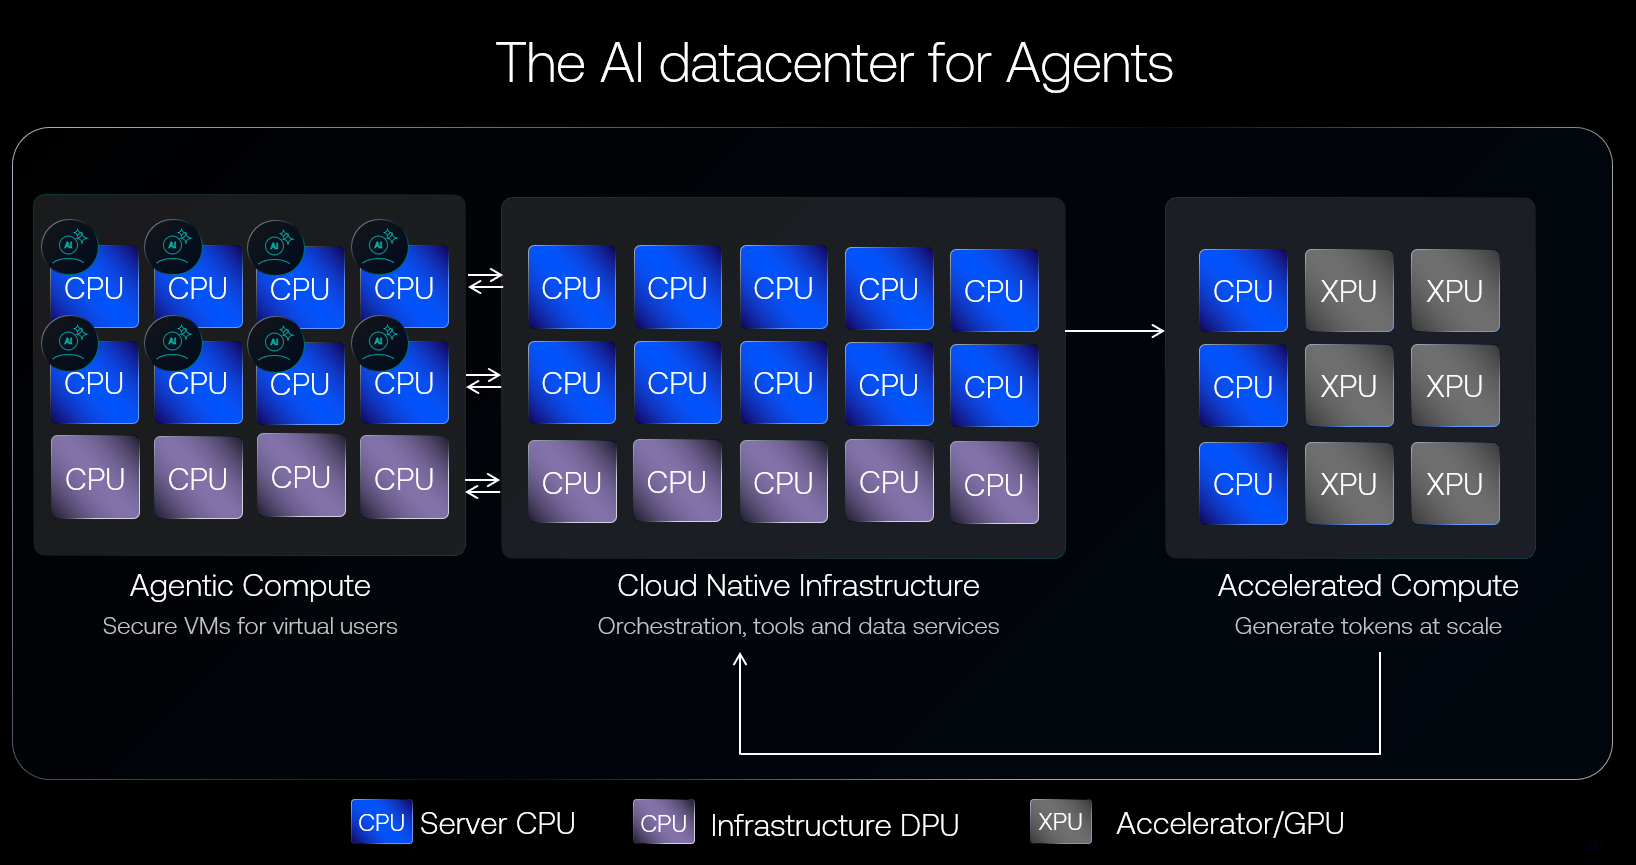
AI 智能体仍处于早期的发展阶段,但使用规模正快速增长。根据美国知名风险投资机构 a16z 援引的 OpenRouter 数据,自2026年 2 月以来,智能体的 Token(词元)使用量增长约 14 倍。从基础设施的角度来看, AI 智能体就像拥有持久计算环境的虚拟用户,能够持久保持状态、检索上下文、调用工具和服务、执行任务,并持续评估执行结果,直至任务完成。

CPU

亚马逊云科技与英伟达深化战略合作,计划新增部署200万颗GPU并引入Vera CPU 业界新闻

亚马逊云科技与英伟达深化战略合作,计划新增部署200万颗GPU并引入Vera CPU

8月27日,亚马逊云科技与英伟达宣布大幅扩展双方战略合作。基于16年的联合创新,双方计划在亚马逊云科技的全球基础设施中新增部署200万颗英伟达GPU,并在AI工厂、CPU、网络、开放模型、数据处理和机器人技术等领域深化合作。此次合作还涉及将英伟达Vera CPU引入亚马逊云科技,以及下一代Amazon Trainium芯片支持NVLink Fusion高速互连技术。

CPU Nvidia(英伟达)

海光首发“Agent to Token开放计算架构”,CPU+DCU双芯协同打通词元经济算力闭环 行业活动

海光首发“Agent to Token开放计算架构”,CPU+DCU双芯协同打通词元经济算力闭环

8月27日,2026中国国际大数据产业博览会在贵阳开幕。海光信息在会上首发“Agent to Token开放计算架构”,该架构依托CPU与DCU双芯协同及开放互连,面向词元经济规模化发展提供从芯片到应用的算力框架。随着大模型加速向产业渗透,Agent正成为AI落地的核心载体,词元的生成效率、单位成本与供给稳定性直接影响Agent应用深度。海光此次发布的架构将Agent调度与词元生成纳入统一体系,CPU承担业务流系统枢纽,DCU聚焦并行计算加速,并支持算力、互连、安全、软件栈四维开放,为国产算力在智能经济时代的体系化能力升级提供了新的路径选择。

CPU

特别推荐

更多

行业动态

更多

技术应用

更多

选型替代

更多

产品信息

更多

热门搜索

更多

欢迎登录

没有账号,

账号注册

注册成功!

3S后自动为你跳转登陆