【导读】2026人工智能计算大会上,浪潮信息正式推出元脑SD200 Ultra超节点AI服务器与元脑HC2000多元算力机组,针对Agent时代大模型高参数、低时延、长稳运行的核心需求,实现本土智算硬件的关键性能突破。全新元脑SD200 Ultra依托国产化AI芯片架构优化,可单机承载2.8万亿参数Kimi K3大模型运行,将Token生成时延压缩至5.85毫秒,同时支持10万亿参数前沿模型部署,凭借架构、通信、算子的全方位优化,补齐了本土超算支撑高阶智能任务的能力短板,为智能规模化落地提供高性能算力底座。
随着大模型与Agent的发展,AI正在从"回答问题"走向"解决问题",智能也逐步成为可以规模化生产和供给的资源。浪潮信息认为,Agent时代的AI计算正在形成两个同样重要的发展方向:
Capability AI Compute,即能力型智算,支撑突破智能上限,让AI帮助人类探索未知、解决过去解决不了的问题;
Capacity AI Compute,即容量型智算,实现智能充分供给,让高水平智能越来越丰富、越来越经济、越来越易于获取。
前沿模型不断演进,对AI计算系统提出更高要求
AI正在不断突破人类认知和任务能力的边界,从更大规模模型到更复杂的Agent,前沿智能持续演进。但模型能力的突破,并不意味着这些能力就能直接被使用。只有计算系统能够跟上前沿智能的发展,让更大的模型承载得住、更低的时延支撑得起、更长的任务稳定运行,模型能力才能真正转化为可用的智能。
第一,要跟上模型前沿的发展速度。前沿模型正在多个维度持续扩展:参数规模从DeepSeek R1的6710亿增长到Kimi K3的2.8万亿,并进一步走向10万亿级;上下文从128K扩展到1M以上;Agent也从单体工作走向成百上千个Agent协同。模型权重、KV Cache和并发任务规模同步增长,对显存容量、高速互连和并行扩展效率提出了更高要求。这需要AI计算系统将足够多的计算、内存和通信资源高效组织起来,以支撑前沿模型真正运行。
第二,要满足越来越低的推理时延。复杂Agent任务往往包含大量"推理—工具调用—反馈—重新规划"循环,每一轮时延都会累积到最终任务时间。更重要的是,前沿智能正在从离线分析走向实时决策:生产系统发生故障时,Agent需要在故障扩散过程中完成日志分析、根因定位和方案验证;实时科学观测中,智能系统也需要及时识别值得跟踪的目标。时延已经不只是体验指标,而可能直接影响任务能否及时完成。
第三,要支撑Agent任务长稳运行。复杂Agent任务需要连续运行数小时甚至数天,期间经历大量模型调用、工具调用和数据交互。任何一次计算、通信或软件故障,都可能中断整个任务,让此前的推理和执行失去价值。这要求计算系统在持续的模型调用与数据交互中保持稳定,支撑Agent连续推进任务。
5.85毫秒Token生成时延,支撑前沿模型突破智能上限
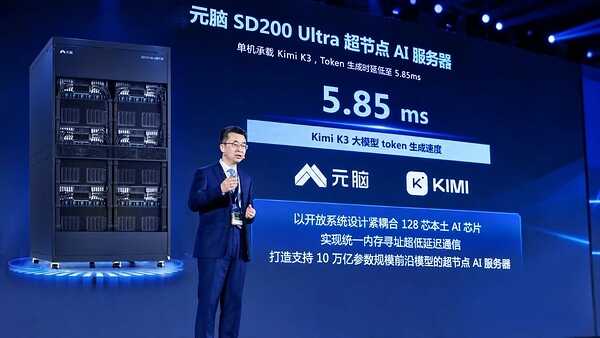
元脑SD200 Ultra基于本土AI芯片,单机承载运行2.8万亿参数的Kimi K3大模型,Token生成时延首次突破5.85毫秒,相当于单用户速度170 Tokens/s,达到业界平均水平的5倍。这不仅突破了基于本土AI芯片超节点对超大规模前沿模型的单机承载能力,也加速释放前沿模型的应用价值。元脑SD200 Ultra这一性能突破,来自于对系统架构、通信机制、算子等全方位优化。
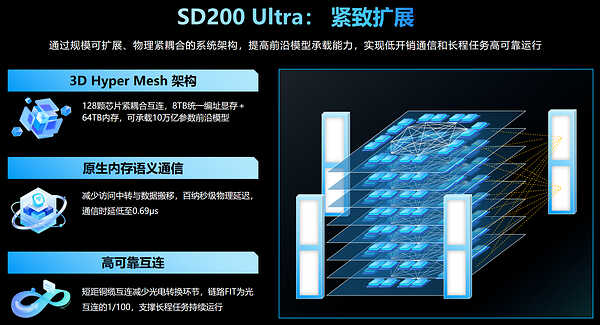
紧致扩展:面对模型参数和KV Cache持续增长,元脑SD200 Ultra采用3D Hyper Mesh架构,以开放系统设计紧耦合128芯本土AI芯片,提供8TB统一编址显存和64TB内存,支持10万亿参数规模的前沿模型单机运行。超节点采用原生内存语义通信,减少跨芯片访问中的中转和数据搬移,通信时延低至0.69微秒。短距铜缆互连设计则减少了光电转换环节,降低链路故障引发任务中断的风险,支撑长程Agent任务稳定运行。
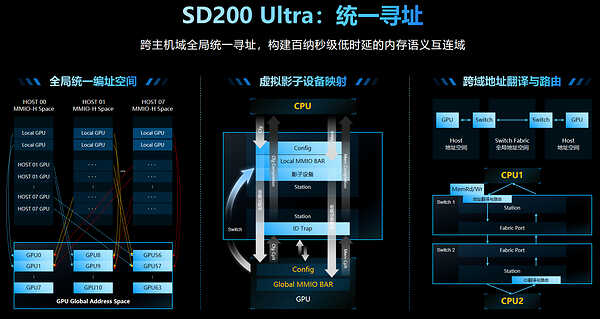
统一寻址:元脑SD200 Ultra通过全局统一编址、虚拟影子设备映射、跨域地址翻译与路由,实现GPU跨主机域的统一寻址访问,构建百纳秒级低时延的内存语义互连域。全局统一寻址使远端资源访问从传统的"消息通信与数据搬移"转变为统一地址空间下的直接访问,降低通信开销,为超节点扩展提供基础。
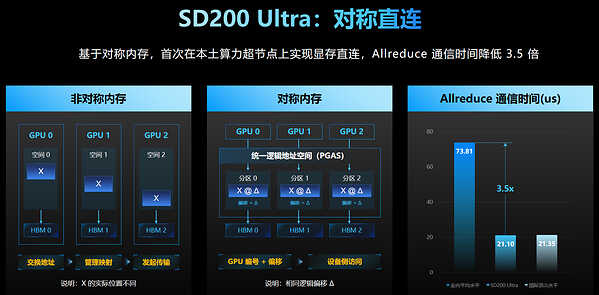
对称直连:在统一寻址的基础上,元脑SD200 Ultra进一步通过对称内存技术,首次在基于本土AI芯片超节点上实现GPU显存直连,使GPU能够像访问本地显存一样直接访问远端GPU显存数据。该技术使得GPU可以直接发起通信,减少地址转换、避免缓冲区中转,缩短数据交换路径,AllReduce通信时间降低3.5倍,达到国际领先水平,有效支撑大模型低时延推理。
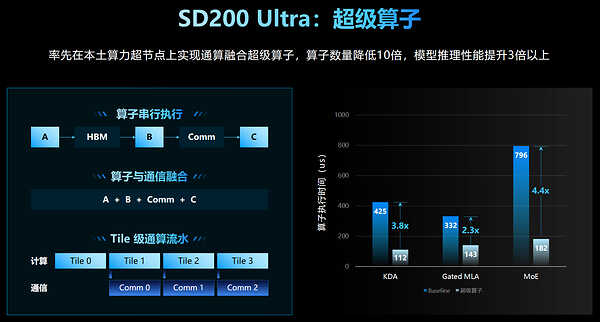
超级算子:要进一步释放超节点性能,还需要优化模型自身的计算过程。针对Kimi K3的推理特点,元脑SD200 Ultra通过使用Kimi K3构建超级算子智能体,率先在基于本土AI芯片超节点上,实现通算融合、Tile级流水的超级算子,将KDA、Gated MLA、MoE中的众多基础算子融合为计算与通信协同执行的大算子,算子数量降低10倍,大幅减少算子启动次数和HBM访问开销,隐藏通信延迟,提升GPU整体执行效率。通过"K3优化K3",实现Kimi K3在元脑SD200 Ultra上的推理性能提升3倍以上。
同时,浪潮信息发布元脑HC2000多元算力机组。元脑HC2000是采用DirectCom 2.0极速架构,基于高密液冷AI整机柜、搭配MCIS推理软件栈,实现计算负载按需匹配、动态优化的多元算力AI服务器机组。同等投资Token产能提升10倍。
从"提供算力"走向"生产智能",浪潮信息将围绕前沿模型和Agent的实际需求,持续推进贯穿式系统创新,让更强的智能能力以可负担的成本进入更多企业和行业应用。
结论
随着大模型与智能体技术快速迭代,AI应用已从基础问答转向复杂自主任务处理,行业对算力体系的要求,从单纯的算力供给升级为高性能、低时延、高稳定的能力型智算支撑。浪潮信息本次发布的两款全新算力产品,精准适配前沿模型超大参数、超低时延推理、长时间稳定运行的核心诉求,通过芯片紧耦合架构、统一内存寻址、对称直连通信与超级算子优化等核心技术,大幅提升本土AI服务器的推理效率与模型承载能力,同时全新多元算力机组有效提升算力投产性价比。这一系列成果标志着本土智算产业从传统算力供给,迈向可支撑高阶智能生产的全新阶段,将持续助力各行业低成本、规模化落地高端AI应用。

 业界新闻