【导读】AI 算力竞争已经不只局限于 GPU 和算力芯片,高速互连传输能力正在成为系统性能的关键。高速 SerDes PHY 作为底层物理层核心 IP,长期由海外厂商主导。本文结合芯耀辉的技术进展,解析高速 SerDes 的技术难点、国内外差距,同时探讨国内厂商如何依托 UCIe、Die-to-Die 等新兴互连场景,走差异化路线,推动国产高速 SerDes 从可用向好用突破。
在AI崛起的早年,半导体行业的主要目光都集中在 GPU、大模型、算力芯片上,但近年来,互连在产业中的重要性与日俱增。
IPnest在一份报告中指出,AI算力的竞争已不再局限于单颗CPU和GPU的性能,而是延伸至整个系统的数据传输与互连能力。要充分发挥核心的计算性能,系统内各个子系统之间必须实现更高带宽、更低延迟的数据传输,这也对底层接口与互连技术提出了更高要求。
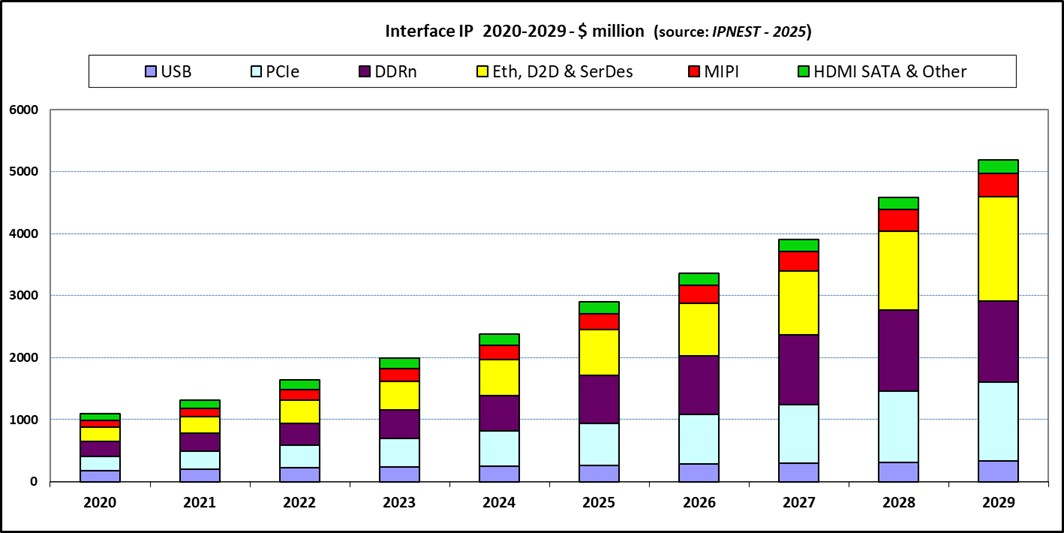
从DDR5、HBM相关的内存控制器与PHY IP,到PCIe、CXL互连接口IP,再到面向高速网络与算力互连的112G/224G SerDes PHY IP,不同层次的接口技术共同支撑新一代AI计算系统。其中,SerDes负责高速串行链路的物理层传输,是影响系统互连带宽、功耗与可靠性的重要环节。
但和很多其他芯片技术一样,高端的SerDes仍然是海外厂商优势显著的市场,本土供应能力的建设因而更受关注。作为一家志存高远的公司,芯耀辉已经成为国产高速SerDes市场不可或缺的中坚力量,公司所提供的SerDes,也因此在本土算力芯片市场中被寄予厚望。
要了解这段话,我们就需要从SerDes这个技术本身说起。
当我们谈SerDes时,谈什么?
顾名思义,由 “Serializer(串行器)” 和 “Deserializer(解串器)”组合而来的SerDes的主要任务是从A端将数据串行起来,再在B端解串以供使用。为什么要这样做?这就与芯片内部的数据处理速度越来越快,数据传输量越来越大,但芯片之间的物理连接数量、功耗和信号完整性都存在限制有关。
芯耀辉高速SerDes产品线总监解释说,芯片内部广泛采用并行总线,但芯片之间若采用大量并行走线,会受到引脚数量、串扰和时序偏差等因素制约。SerDes在发送端将多路并行数据转换为高速串行信号,通过一对差分信号线传输,再在接收端恢复为并行数据。跨机柜或更长距离的连接通常还需要光模块等器件配合。
“这就像把一排要过河的士兵,在桥头收拢成一路纵队过桥,到了对岸再重新展开成横队。”SerDes产品总监举例说。他进一步指出,和列队的士兵一样,SerDes也会面临桥越窄、队伍越长,“收拢”和“展开”的技术要求也更严苛。
在他看来,SerDes的技术难度核心在于速率不断翻倍,但功耗、电压和误码率等约束并没有同步放宽。随着传输速率从56G、112G迈向224G甚至448G,信号必须在更高频率、更大通道损耗和更差信噪比的环境下,仍然保持可靠传输。这对SerDes提出了四个方面的挑战:
1、信号完整性挑战:速率越高,信号对PCB、封装、连接器等传输通道的损耗和串扰越敏感,接收端眼图可能严重闭合,需要依靠复杂的模拟均衡和DSP算法恢复信号。
2、功耗挑战:SerDes涉及PLL、驱动器、接收均衡器和时钟数据恢复等复杂电路。以配置512条高速SerDes通道的交换芯片为例,若每通道增加5毫瓦功耗,通道功耗合计就会增加约2.56瓦。因此,如何在提升带宽的同时控制每比特能耗,至关重要。
3、工艺与封装协同挑战:先进FinFET工艺的低电压特性增加了模拟电路设计难度,而2.5D/3D封装又改变了信号传输通道和设计要求。SerDes设计已经不再是单纯的电路设计,而是需要工艺、封装、PCB、协议和系统层面的协同优化。
4、可靠性与量产经验挑战:仿真通过并不意味着芯片在真实客户环境中就能稳定工作。不同封装、PCB设计、温度范围和应用场景都会带来新的边界条件,需要通过长期流片、回片测试和客户项目积累经验。
归根结底,SerDes的竞争不只是比拼单通道传输速率,更是信号完整性、功耗、工艺封装协同以及长期量产可靠性的综合较量。 面向不同工艺平台与应用场景,SerDes IP的突破不仅需要资金和研发投入,更需要长期流片验证和真实客户项目的积累,这也是SerDes技术壁垒难以通过短期投入快速追平的原因。
尤其是在国内,实现国产SerDes的高端突破,迫在眉睫。2026年9月发布的《电子信息制造业发展“十五五”规划》已首次将IP核(知识产权核)单列为独立细分领域,而高速SerDes正是其中技术门槛最高的方向之一。
巨头环伺,芯耀辉悄然崛起
为什么要关注高速SerDes?如文章开头所说,这首先因为需求的转变。以AI GPU为例,随着对外互连带宽提升至1.6TB/s至3.2TB/s与内部HBM访问带宽达到数TB/s,SerDes已成为AI芯片和服务器集群中功耗、芯片面积及封装资源的重要组成部分。
“在高带宽交换芯片中,SerDes是面积与功耗预算的重要组成部分。GPU提供计算能力,而SerDes与交换架构、互连协议等共同影响万卡级AI集群的数据传输效率,是释放超大规模集群算力的关键环节。”芯耀辉SerDes产品总监表示。
但是,在全球高速SerDes产业中,可以看到两类主要参与者:一类是对外授权的IP供应商,当中以Synopsys(新思科技)、Cadence(楷登电子)和Alphawave Semi(高通于2025年12月完成收购)为代表;另一类是以自研SerDes支撑自身芯片产品的公司,Broadcom(博通)、Marvell(美满电子)和NVIDIA(英伟达)就是其中的头部玩家。
“这些公司共同的特点是长期的技术与工程积累,从最早的 1G、2G、5G,一路走到今天的 112G/224G,下一代448G也已进入行业技术路线图与前沿研究。这些厂商掌握的不是某一个电路图,而是大量芯片在不同工艺、不同板级、不同封装条件下积累的工程数据库和调校经验。”芯耀辉SerDes产品总监接着说。
换而言之,打造高速SerDes并非一朝一夕之功。面向112G/224G及更高速率,厂商需要结合不同工艺平台的器件特性、供电条件与封装约束,选择适合目标场景的架构,在性能、功耗和面积之间取得平衡。
基于多年的积累,芯耀辉已经成为了这个赛道的国内头部厂商。公司正围绕本土算力客户的需求推进产品研发,与国际巨头相比,在部分细分方向上也不落下风。据了解,芯耀辉112Gbps SerDes PHY已开展样片测试,UCIe并口PHY已通过多个头部客户项目验证,能满足AI芯片Scale-Up互连需求。
能在巨头环伺的市场达成这样的成就,按照芯耀辉SerDes产品总监所说,这主要得益于公司围绕AI时代高速互连需求,采取聚焦核心接口、差异化技术竞争和深度客户协同三条策略:
首先,芯耀辉聚焦AI高速互连核心接口,重点布局高速SerDes PHY、Die-to-Die、UCIe及Memory Interface;其次,以差异化实现竞争,面向多元化工艺平台与国内AI集群应用场景,在低功耗、低延迟、小面积等方面打造产品优势;再者,公司从成立伊始就不局限于标准化IP销售,而是提前介入客户芯片架构设计,从SerDes Lane数量、功耗预算、通道规划到封装协同,提供全栈式接口IP解决方案。通过这种与客户共同定义产品并提供深度工程服务的方式,芯耀辉建起了较强的竞争优势。
在芯耀辉等企业的努力下,国产 SerDes 正在从“能用”走向“好用”。在中低速上,比如 10G、25G、32G,国内已经有不少公司能提供成熟 IP,也在大量国产交换、网卡、终端芯片里量产。在高速上,56G PAM4已有国内厂商提供商用IP产品;112G PAM4 这一代,不同厂商、工艺平台及应用场景的成熟度存在差异,应区分流片、样片测试、客户系统验证与量产等阶段。
就芯耀辉而言,本文披露的112G PHY进展为已开展样片测试。面向224G产品,芯耀辉也已经在预研阶段。但是,如该公司产品总监所说,虽然进步明显,但本土SerDes差距依然存在。
要更进一步,就需要国内企业适应本地需求,蹚出一条属于中国SerDes的发展道路。
群策群力,引领国产SerDes突围
“与Synopsys、Cadence以及Alphawave等国际巨头相比,本土SerDes 差距主要体现在代际完整度、工程数据库与案例数以及系统级协同能力三方面。”芯耀辉SerDes产品总监表示。
所谓“代际完整度”,是指国际主要供应商在多个速率等级、传输距离和工艺平台上形成了较丰富的产品组合,部分产品已覆盖224G。作为对比,国内厂商往往先在特定速率、工艺或应用场景中突破,产品组合仍需持续完善。
“工程数据库与案例数”则体现为长期流片、工艺适配、回片测试与客户部署所积累的数据。这些经验有助于识别仿真与实测之间的偏差、完善校准策略并提高交付的可预期性。国内厂商仍需通过持续的客户项目积累,扩大工程验证覆盖面。
至于“系统级协同能力”,则主要因为当下最先进的 SerDes 已经不是单独一颗 IP 的事,而是要和 Retimer、Redriver、光模块 DSP、交换芯片、PCB 板材做联合优化。国际产业链在PHY IP、Retimer和光DSP等环节已有成熟供应商,并形成了较完善的协同生态;国内产业链仍需加强跨环节的联合验证与适配。
“差距是追赶的空间,不是绝望的鸿沟。因为 AI 这波浪潮把整个赛道的规则重新洗了一遍——短距D2D、UCIe、CPO、UALink等方向的发展,为本土厂商创造了新的切入机会,但国际厂商已有的技术与生态积累仍不可忽视。”芯耀辉SerDes产品总监强调。基于这一判断,他为中国SerDes产业的突围提出了四个方面的行动建议。
第一,不能等“性能全面追平”,要先在新场景里建立根据地。
相比在国际巨头已经建立深厚优势的传统数据中心互连市场正面竞争,国产厂商不妨优先布局AI芯片D2D互连、UCIe芯粒接口以及NPO/CPO配套短距SerDes等新兴应用场景。这些领域仍处于快速发展阶段,技术路线和市场格局尚未完全固化,虽然国际厂商已有布局,本土厂商仍可围绕具体需求寻找差异化机会。国产厂商可以借助更贴近本土客户、响应速度更快以及定制化服务更灵活等优势,通过差异化竞争率先建立市场基础。
第二,不能只做“模拟电路”,要做“模拟 + 数字 + 系统”的混合能力。
未来的高速SerDes,竞争点不再局限于模拟前端(AFE),而是覆盖模拟电路、ADC/DAC架构、DSP算法、链路自适应以及与目标协议和系统架构的协同。不同应用对传输距离、能耗与时延的要求各不相同,厂商需要根据目标场景选择架构,并通过系统级验证形成可交付能力。
第三,不能靠一家公司单打独斗,要靠“国产系统”一起跑通。
SerDes 是要被装进客户芯片里的 IP,客户不会为了支持国产而冒流片失败的风险。所以国产SerDes厂商必须和国内的 Foundry、封装厂、板卡厂、整机厂、光模块厂一起,从工艺 PDK 到通道模型到整机验证,做整条链路“端到端”的联合打磨。芯耀辉这两年做的一个很重要的工作,就是与工艺及封测合作伙伴开展协同,围绕通道建模、封装寄生参数提取与可靠性验证开展联合优化,让客户“能用”“敢用”“好用”。
第四,不能只盯着国内市场,要从定义开始就按国际标准做。
面向全球生态,SerDes IP需要依据目标应用满足相应的电气与协议规范,例如OIF CEI、IEEE 802.3,以及适用的PCI-SIG规范;接入特定厂商生态时,还需满足其技术规范与授权要求。除协议兼容与互操作验证外,IP集成还需要评估工艺平台、金属层、宏单元尺寸、凸点布局以及性能、功耗和面积(PPA)目标,降低客户的适配与验证成本,才能更好地进入全球供应链。
芯耀辉SerDes产品总监总结说,高速SerDes 看上去是一个很窄、很硬核的技术 IP,但它其实是整个中国半导体产业从“单点突破”走向“系统能力”的一个缩影。
“这条路很长,也很孤独,需要时间、需要耐心、需要一整代工程师坐冷板凳。但方向是清楚的:AI 的潮水已经把整个行业的接口标准重新洗了一遍,这是国产高速 SerDes 距离全球第一梯队最近的一次机会。芯耀辉愿意做这支过桥队伍的排头兵,也欢迎产业链上的伙伴和我们一起,把这条路走通。”该产品总监强调。
结论
高速 SerDes 比拼的不只是单通道速率,更是信号完整性、功耗控制、工艺封装协同与长期量产验证能力。国内赛道已经在中低速 SerDes 实现量产落地,112G 及以上高速产品正处在验证爬坡阶段。依托 UCIe、D2D、CPO 等新兴互连赛道,产业链协同打磨端到端链路,是国产 SerDes 缩小差距、实现突围的可行路径。

 新品速递